|
|
Grok支持以正则表达式的方式提取所需要的信息,正则表达式又分两种,一种是内置的正则表达式,一种是自定义的正则表达式,例如:
内置的正则表达式方式,下面的写法表示从输入的消息中提取IP字段,并命名为sip;
%{IP:sip}
自定义的正则表达式,开始与终止符分别为(?与?),下面的写法表示获取除,以外的字符,并命名为log_type;
(?<log_type>[^,]+?)
Grok具体的语法参数如下:
%{SYNTAX:SEMANTIC}
`SYNTAX`代表匹配值的类型,例如,`0.11`可以`NUMBER`类型所匹配,`10.222.22.25`可以使用`IP`匹配;
`SEMANTIC`表示存储该值的一个变量声明,它会存储在`elasticsearch`当中方便`kibana`做字段搜索和统计,你可以将一个`IP`定义为客户端IP地址`client_ip_address`
例如:`%{IP:client_ip_address}`,所匹配到的值就会存储到`client_ip_address`这个字段里边,类似数据库的列名,也可以把event log中的数字当成数字类型存储在一个指定的变量当中,响应时间`http_response_time`;
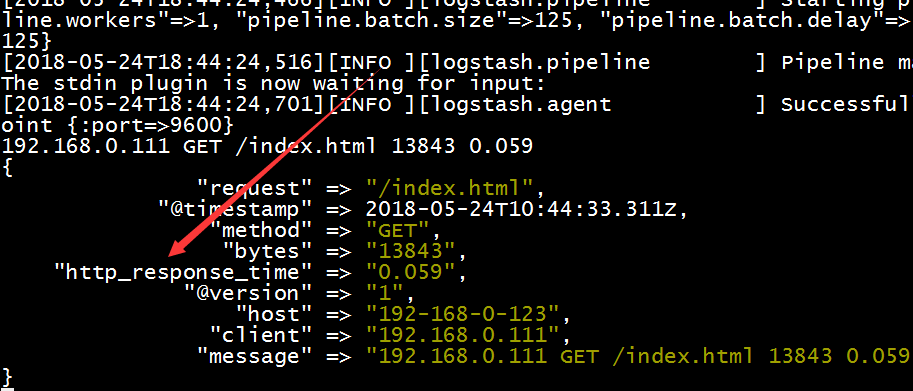
Grok文本片段切分的案例一:
input {
stdin {}
}
filter {
grok {
match => { "message" => "%{IP:client} %{WORD:method} %{URIPATHPARAM:request} %{NUMBER:bytes} %{NUMBER:http_response_time}" }
}
}
output {
stdout {
codec => "rubydebug"
}
}
192.168.0.111 GET /index.html 13843 0.059
Grok文本片段切分的案例二: |
|


 发表于